


پشت پرده هوش مصنوعی | قسمت ۴۶: Speculative Decoding چیست؟
وقتی یک مدل زبانی بزرگ قرار است پاسخی…
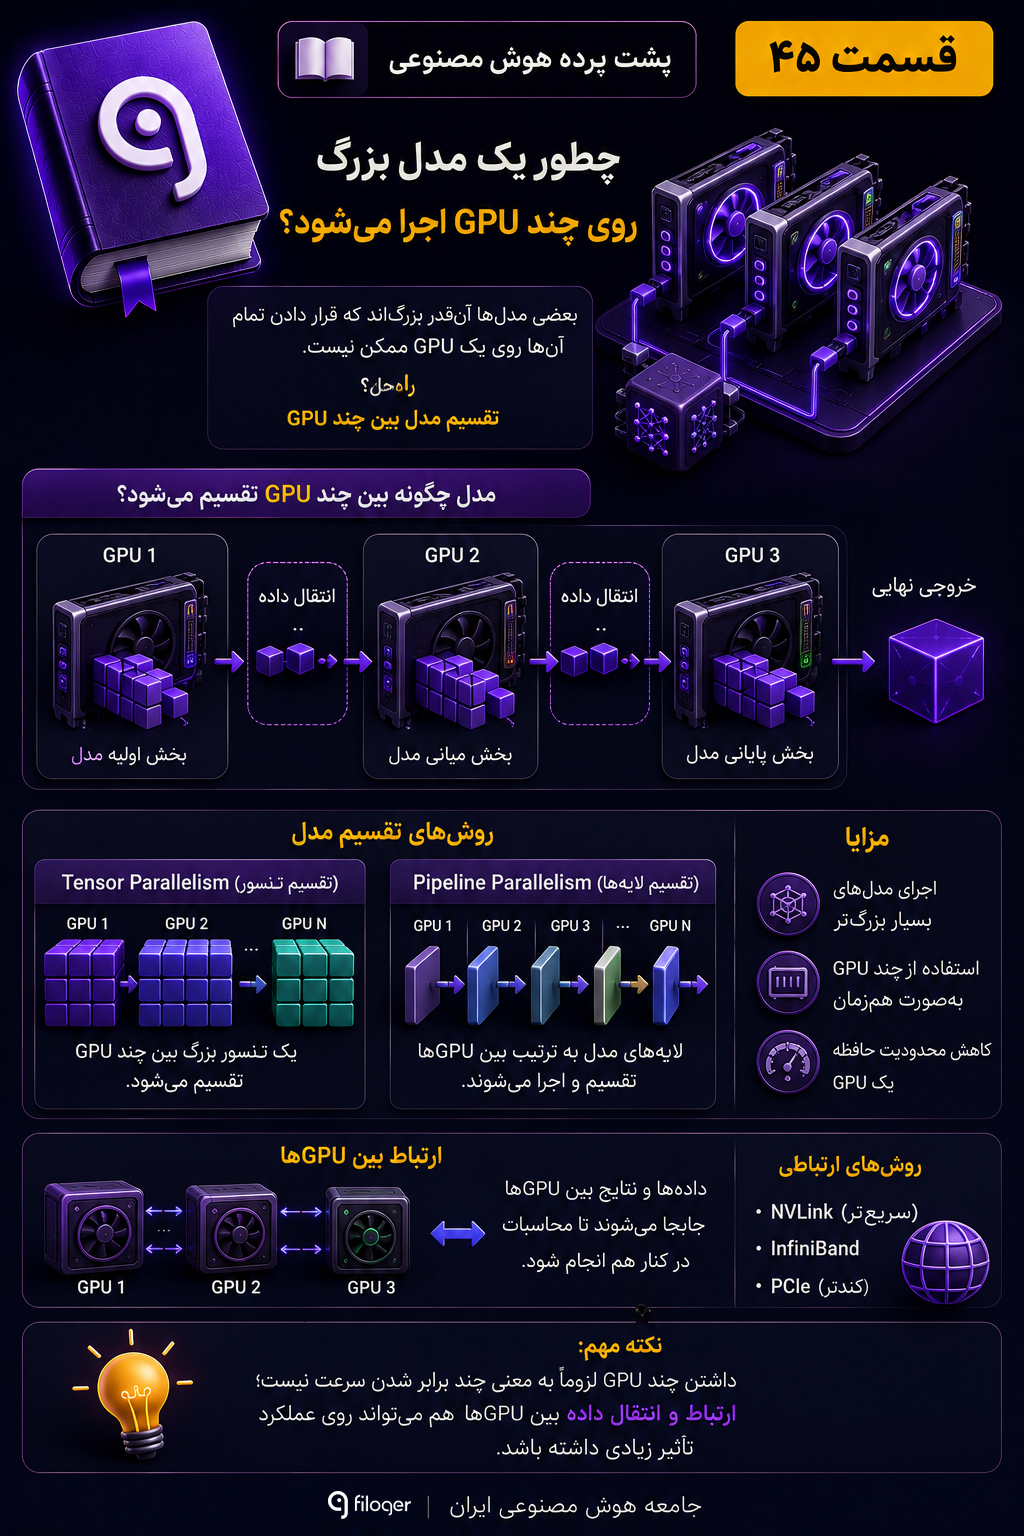
پشت پرده هوش مصنوعی | قسمت ۴۵: چطور یک مدل بزرگ روی چند GPU اجرا میشود؟
مدلهای هوش مصنوعی امروزی میتوانند بسیار بزرگ باشند.…

پشت پرده هوش مصنوعی | قسمت ۴۴: چرا GPU همیشه کافی نیست؟
وقتی درباره اجرای مدلهای هوش مصنوعی صحبت میکنیم،…
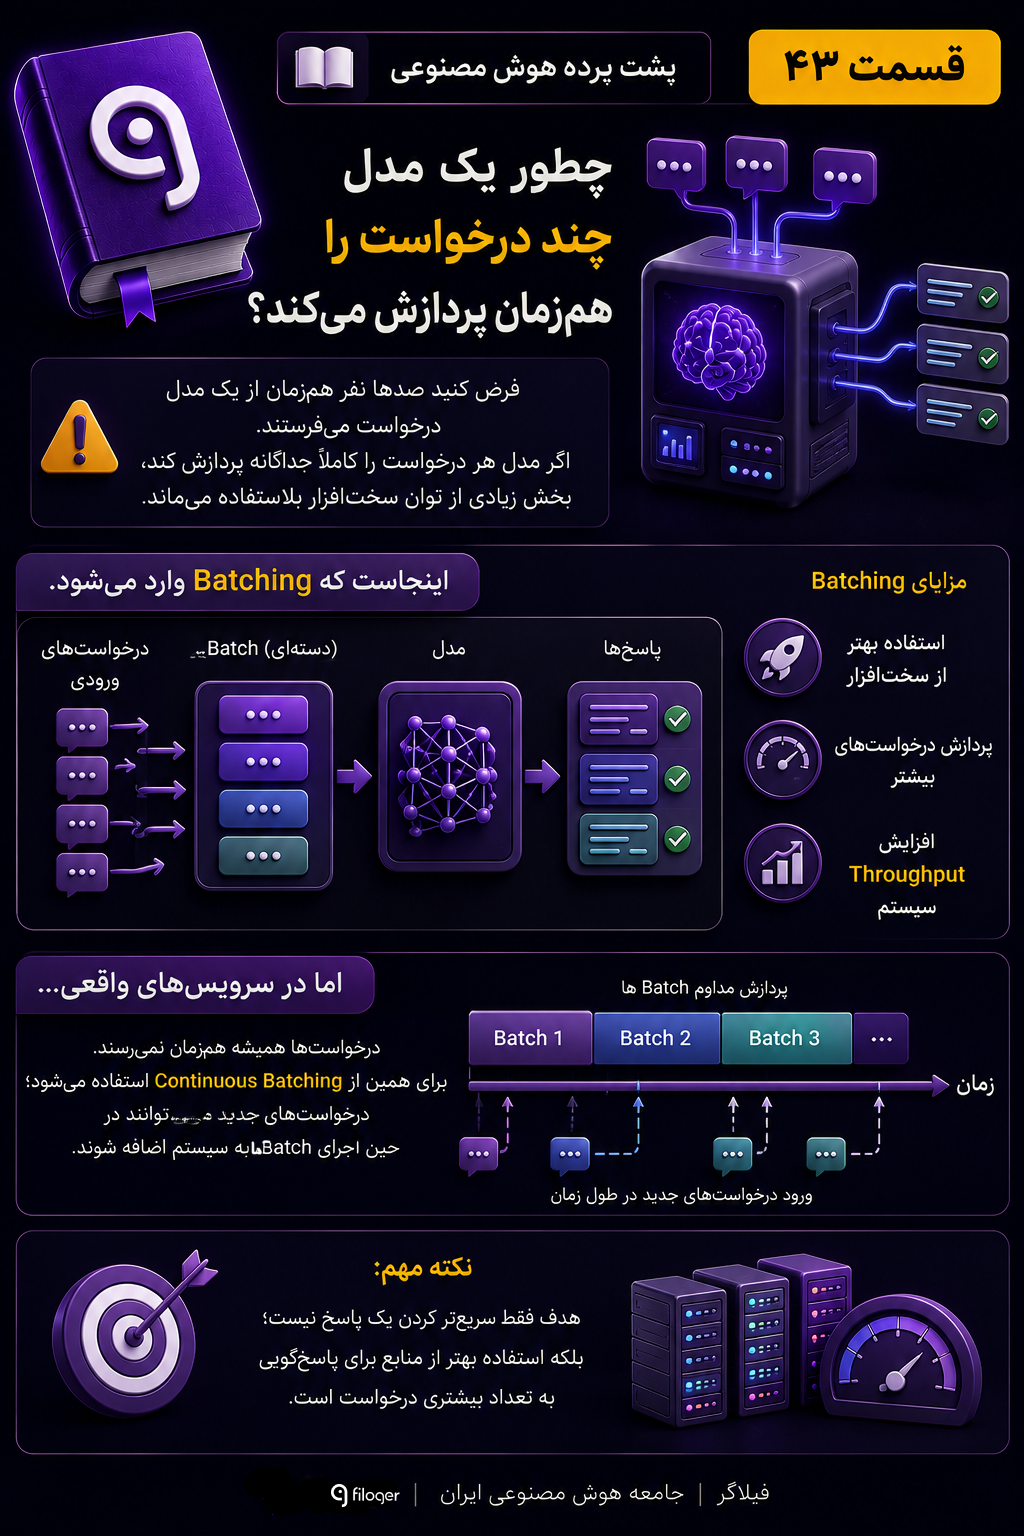
پشت پرده هوش مصنوعی | قسمت ۴۳: Batching در هوش مصنوعی چیست؟
وقتی تعداد زیادی کاربر بهصورت همزمان از یک…

پشت پرده هوش مصنوعی | قسمت ۴۲: تفاوت مدل Dense و MoE چیست؟
تا اینجا در مجموعه «پشت پرده هوش مصنوعی»…
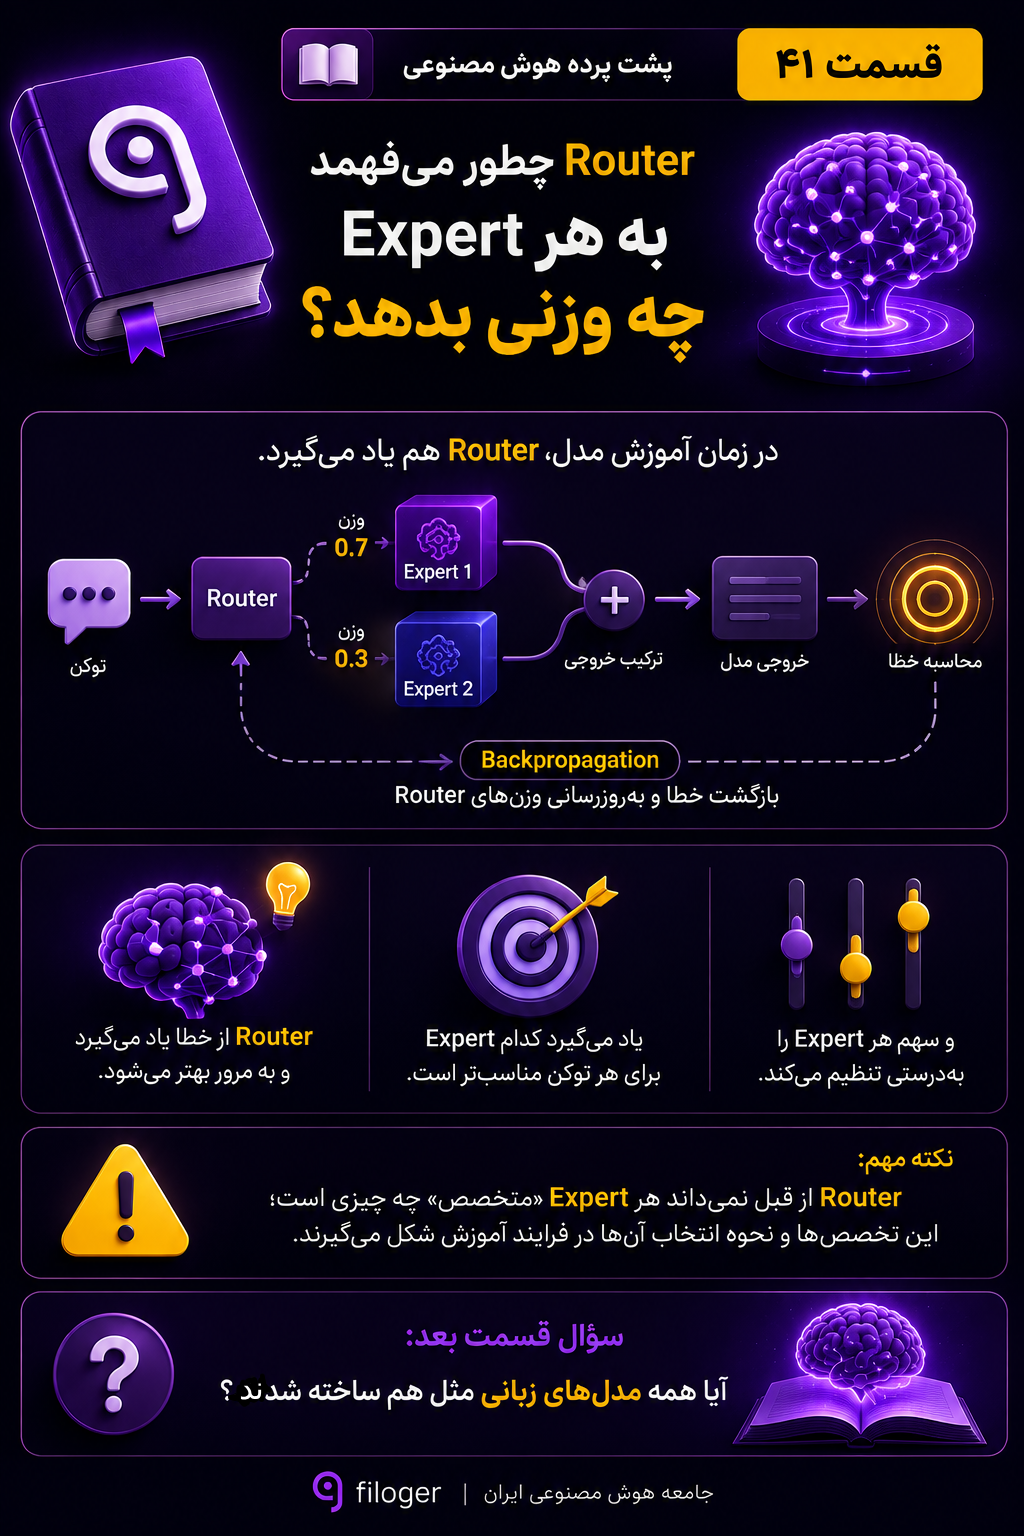
پشت پرده هوش مصنوعی | قسمت ۴۱: Router در مدل MoE چگونه یاد میگیرد؟
در قسمت قبل از مجموعه «پشت پرده هوش…

پشت پرده هوش مصنوعی | قسمت ۴۰: ترکیب خروجی Expert در مدل MoE چگونه است؟
در قسمت قبل از مجموعه «پشت پرده هوش…

پشت پرده هوش مصنوعی | قسمت ۳۹: Top-k Routing در مدلهای MoE چیست؟
در قسمت قبل از مجموعه «پشت پرده هوش…
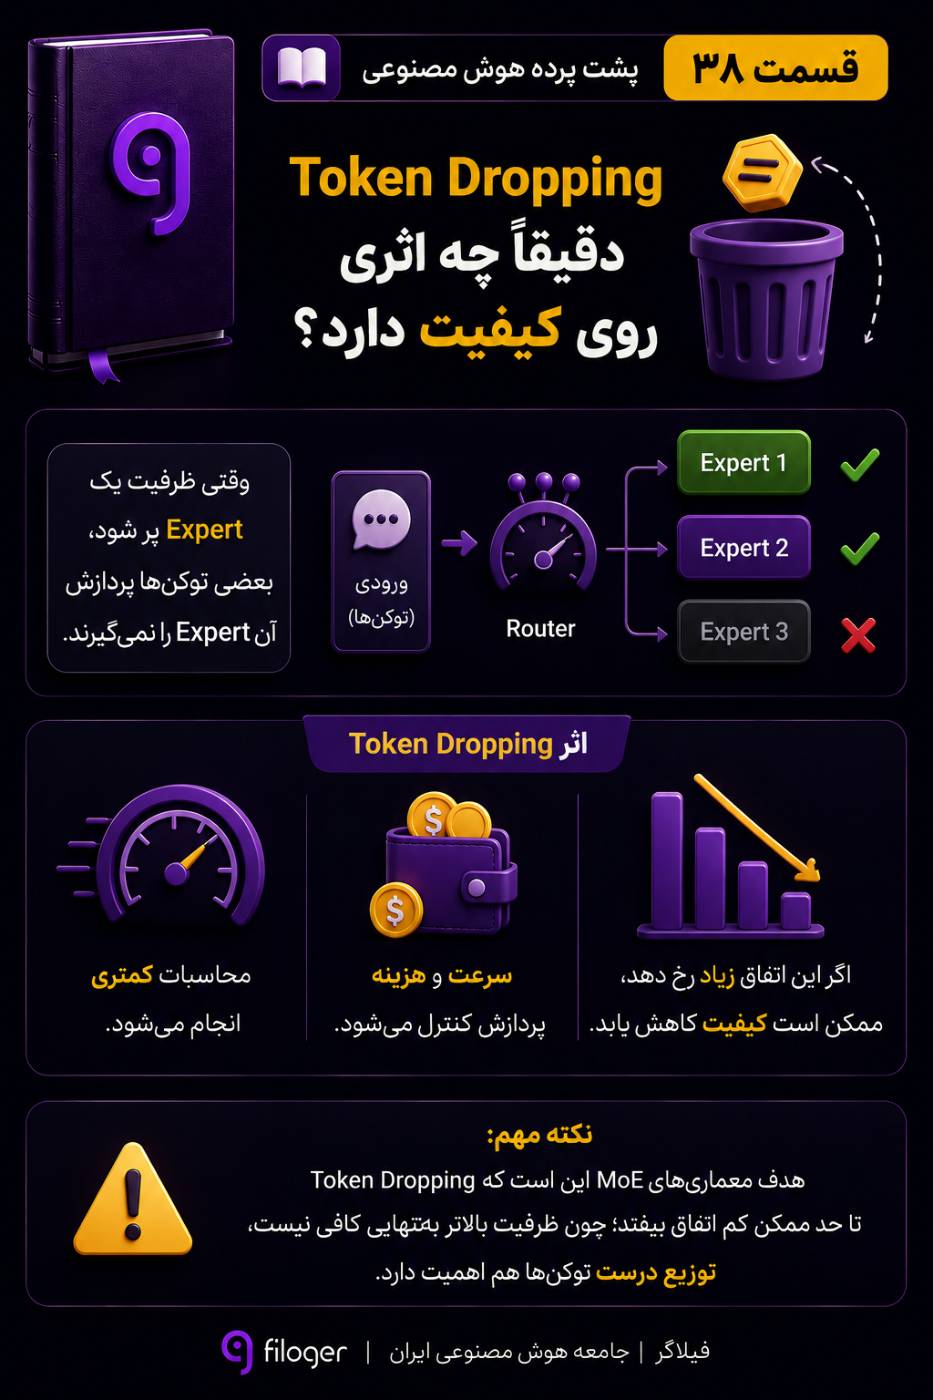
پشت پرده هوش مصنوعی | قسمت ۳۸: Token Dropping در مدلهای MoE چیست؟
در قسمت قبل از مجموعه «پشت پرده هوش…