

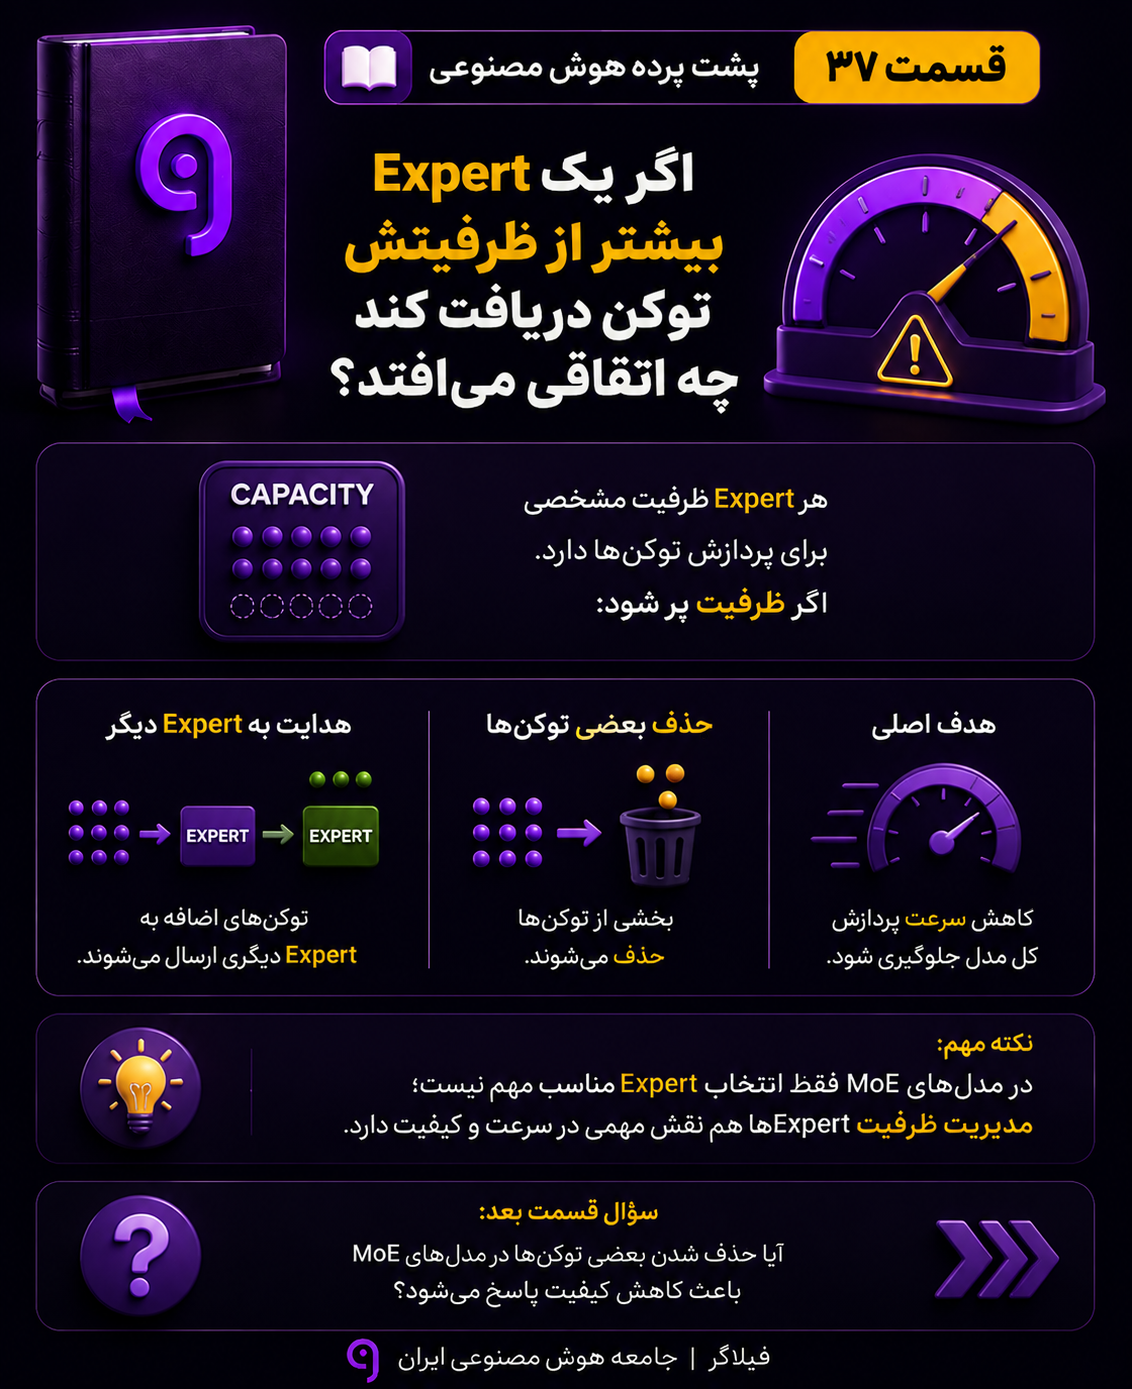
پشت پرده هوش مصنوعی | قسمت 37: اگر یک Expert بیشتر از ظرفیتش توکن دریافت کند چه اتفاقی میافتد؟
در قسمتهای قبل از مجموعه «پشت پرده هوش…

پشت پرده هوش مصنوعی | قسمت 36: چطور مدل Expertها را متعادل نگه میدارد؟
در قسمت قبل از مجموعه «پشت پرده هوش…
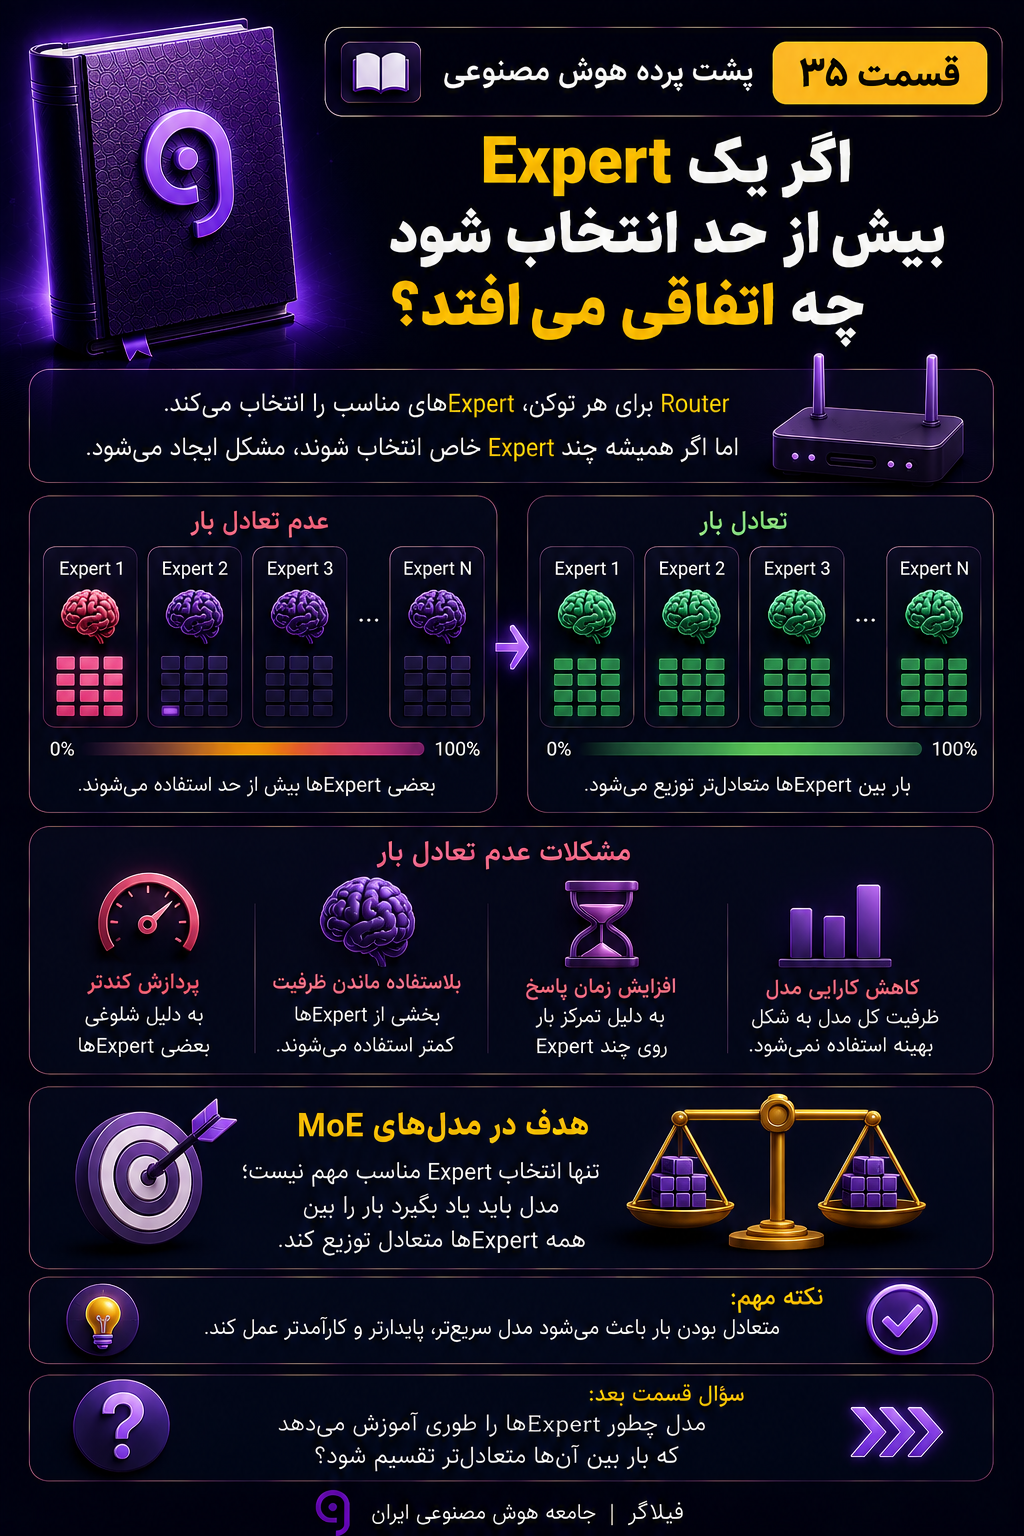
پشت پرده هوش مصنوعی | قسمت 35: Load Imbalance در مدل MoE چیست؟
در قسمت قبل از مجموعه «پشت پرده هوش…
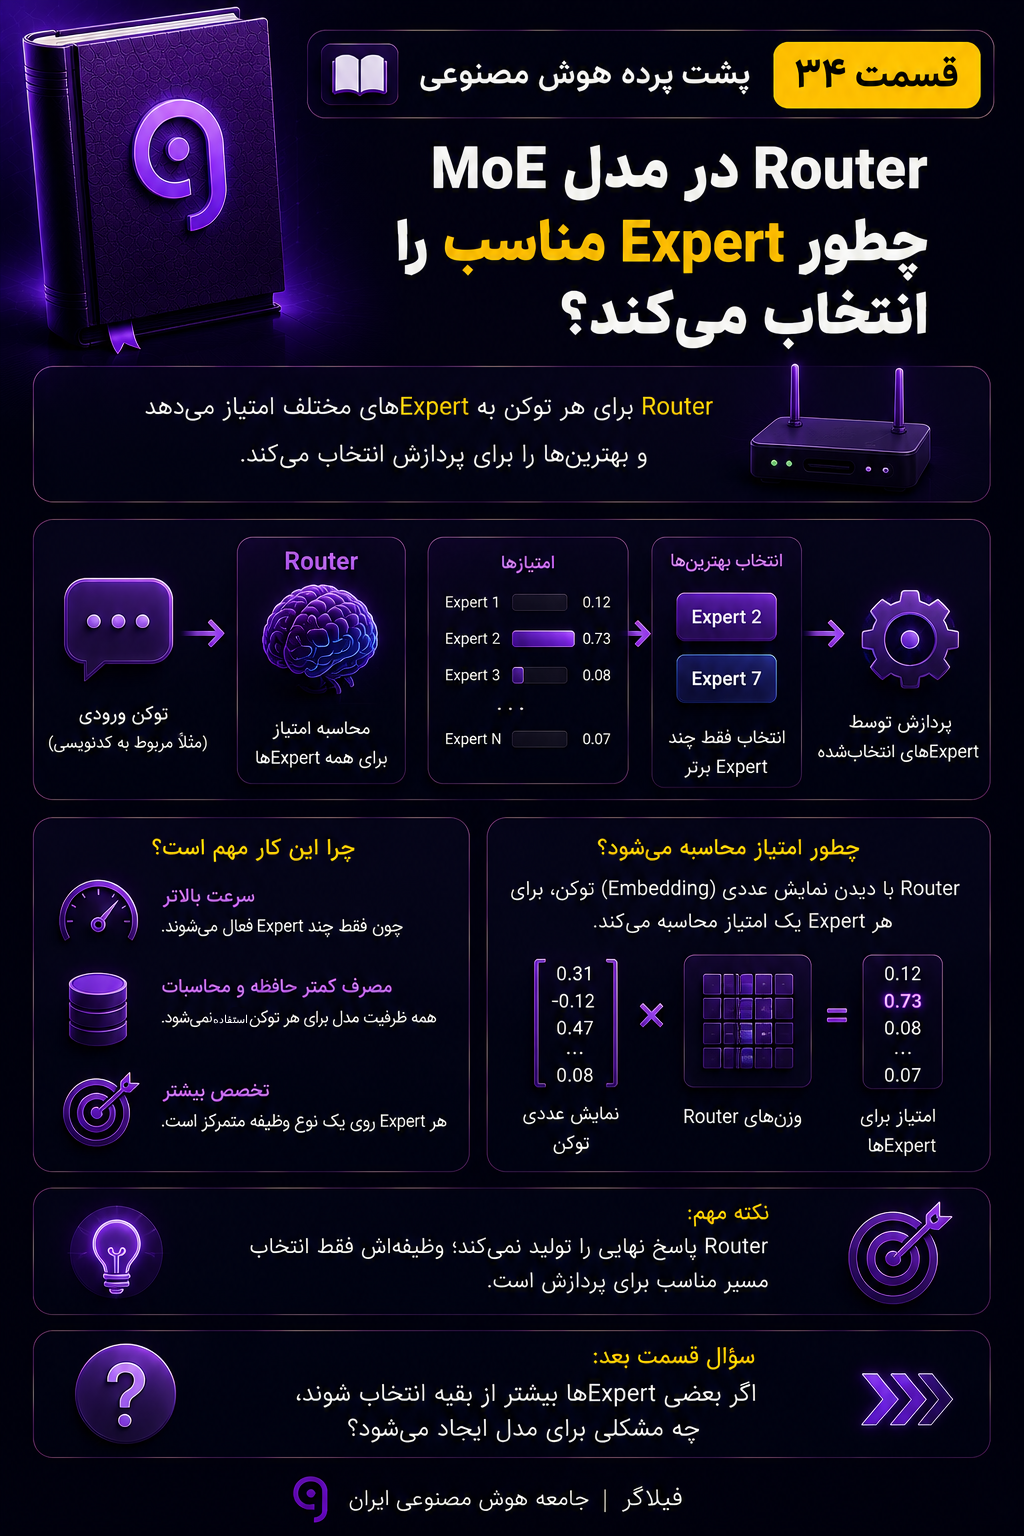
پشت پرده هوش مصنوعی | قسمت 34: روتر در مدل MoE چیست؟
در مدلهای زبانی بزرگ، همیشه لازم نیست تمام…
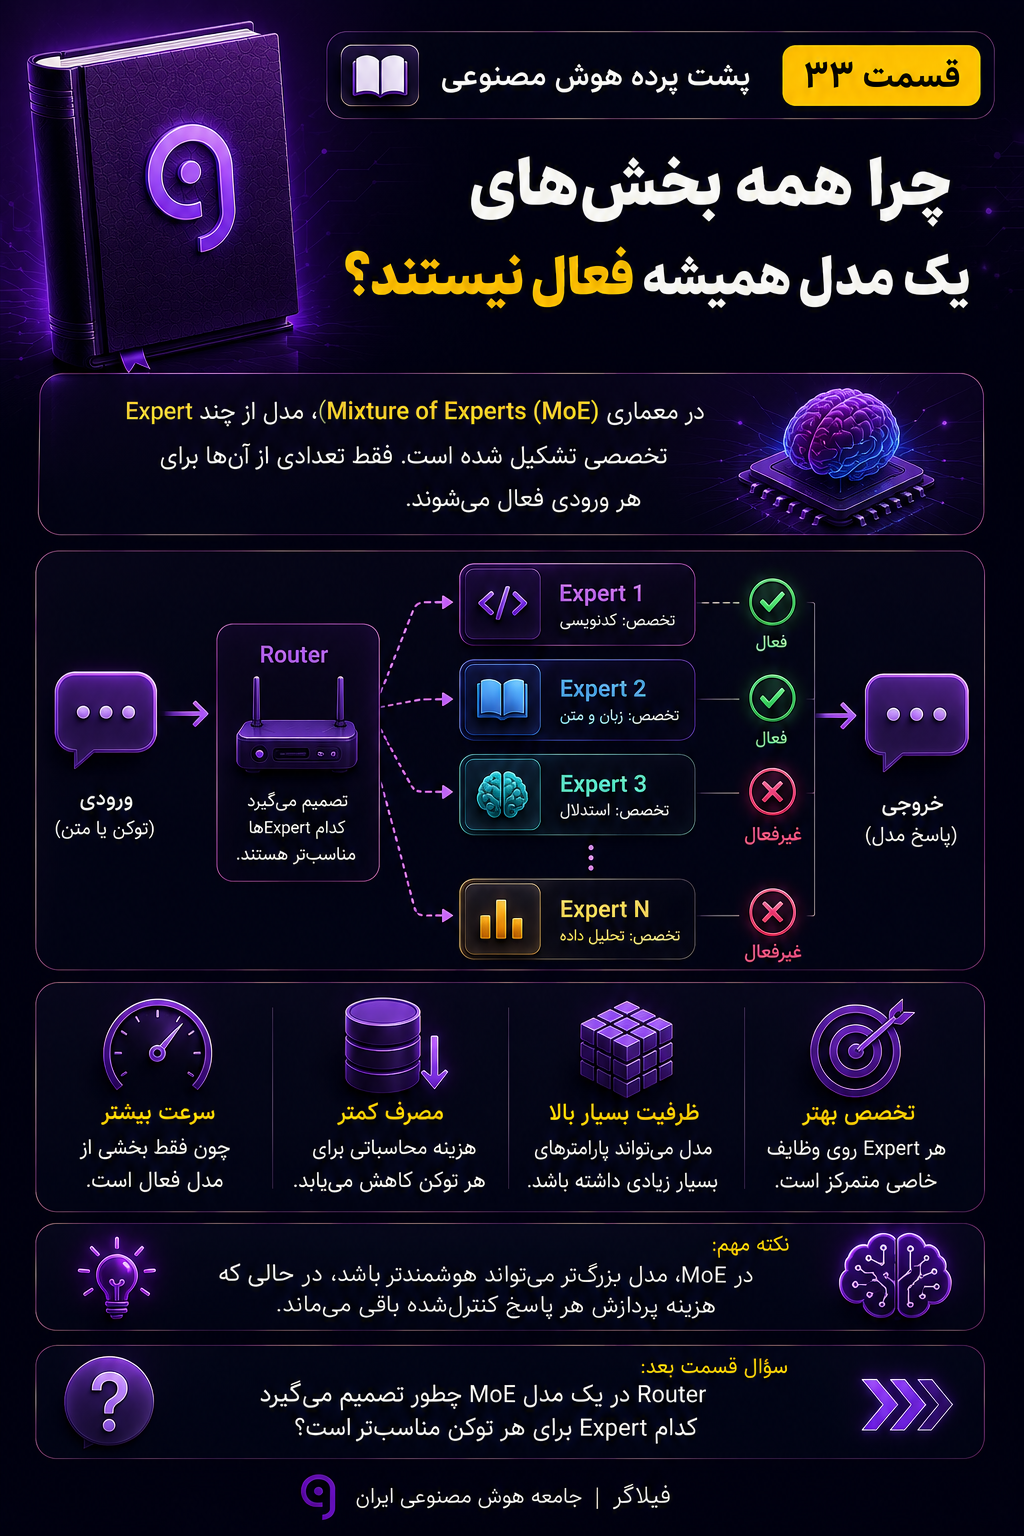
پشت پرده هوش مصنوعی | قسمت 33: معماری Mixture of Experts چیست؟
در مدلهای زبانی بزرگ، تعداد پارامترها میتواند بسیار…
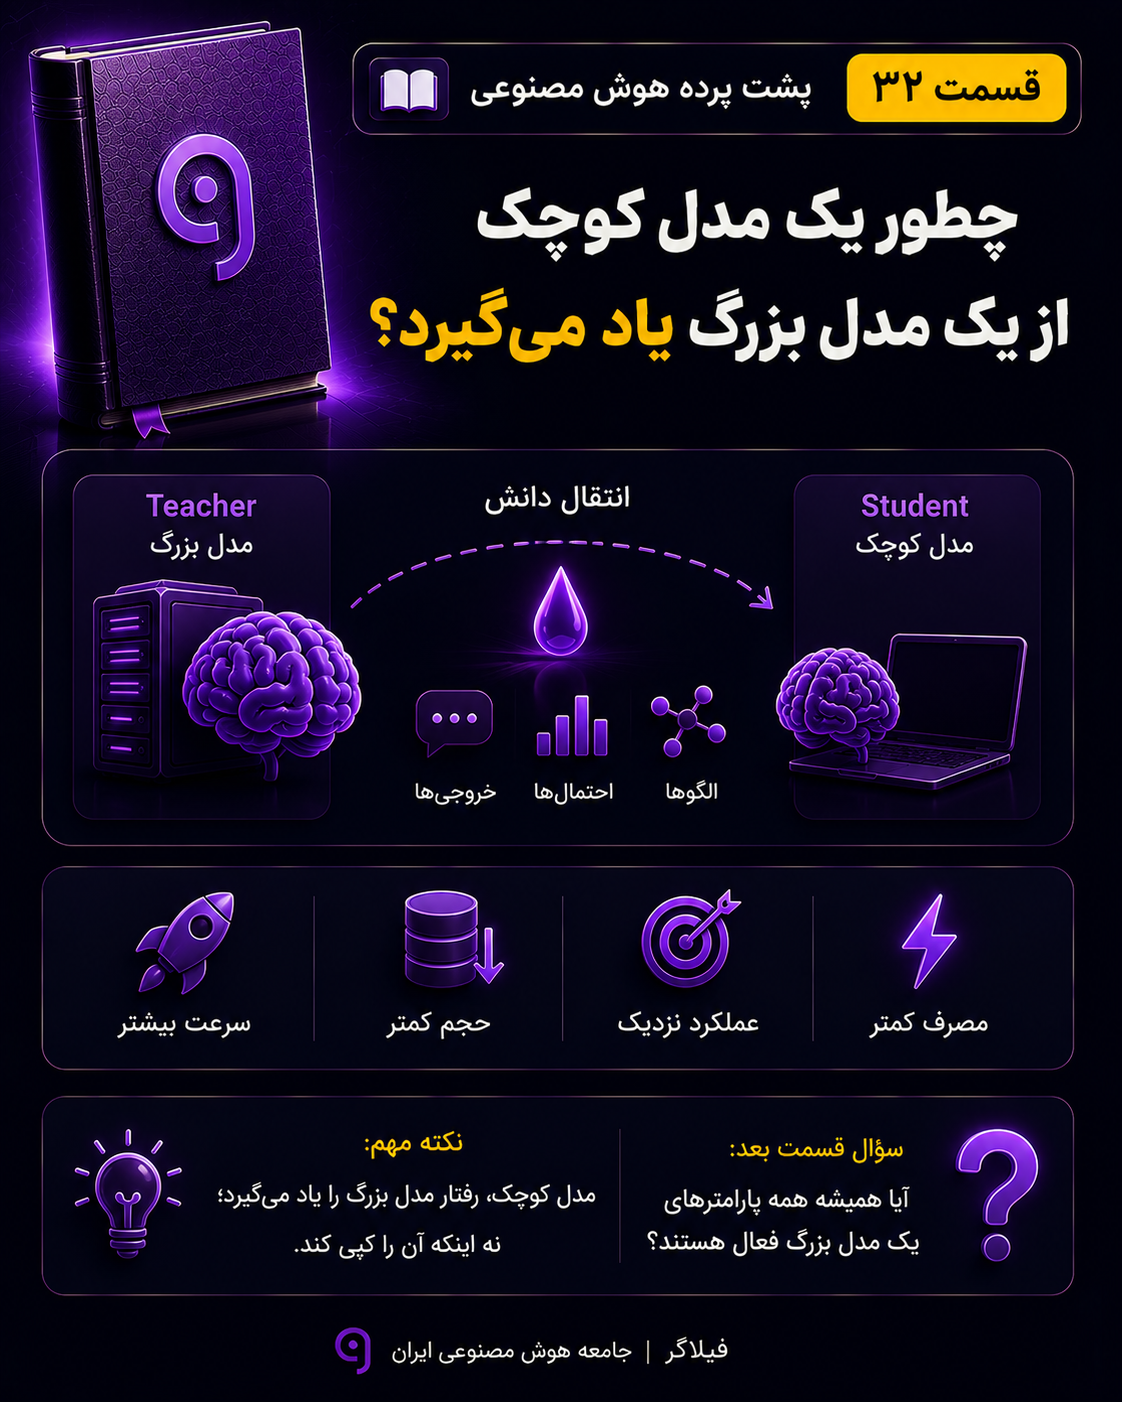
پشت پرده هوش مصنوعی | قسمت 32: Knowledge Distillation چیست؟
در قسمت قبل از مجموعه «پشت پرده هوش…

پشت پرده هوش مصنوعی | قسمت 31: آیا Quantization کیفیت مدل را کاهش میدهد؟
در قسمت قبل با Quantization در هوش مصنوعی…

پشت پرده هوش مصنوعی | قسمت 30: Quantization در هوش مصنوعی چیست و چگونه مدلها را سبکتر میکند؟
وقتی درباره مدلهای بزرگ هوش مصنوعی صحبت میکنیم،…

پشت پرده هوش مصنوعی | قسمت 29: چرا Context Window بزرگ حافظه بیشتری مصرف میکند؟
در قسمت قبل با KV Cache آشنا شدیم…